
0. 배경: 왜 두 개를 다 써봤나
처음엔 3DGS 레퍼런스인 INRIA 구현으로 시작했다. 논문 원본이고 자료도 제일 많으니까. 그런데 [상업 배포 / Fab 마켓플레이스 등록 등 네 상황 기입]를 준비하면서 라이선스를 다시 뜯어봤고, 그 과정에서 gsplat으로 갈아타게 됐다.
이 글은 (B) 기술·구현 관점 비교를 먼저 다루고, (C) 라이선스·상업화까지 포함한 종합 판단으로 마무리한다.
Part B. 기술·구현 관점 비교
1. 두 구현의 정체
INRIA diff-gaussian-rasterization gsplat
| 출처 | Inria / GraphDeco (3DGS 논문 원본) | nerfstudio-project |
| 정체성 | 논문 재현용 레퍼런스 커널 | 재작성된 CUDA 가속 미분 래스터화 라이브러리 |
| 형태 | CUDA 커널 + 얇은 PyTorch 바인딩 | CUDA 커널 + 모듈화된 PyTorch API |
| 유지보수 | 논문 재현 중심, 업데이트 뜸함 | 활발히 유지보수, 기능 확장 지속 |
| 라이선스 | 비상업(non-commercial) | Apache 2.0 |
| 학습 메모리 | 기준 | 대규모 씬에서 최대 ~4배 절감 |
| 학습 시간 | 기준 | 최대 ~15% 단축 (작은 씬은 역전 가능) |
| 추가 기능 | 원 논문 범위 | 배치 래스터화 · 깊이 렌더 · N-D 피처 · 멀티-GPU · absgrad · anti-aliasing · MCMC 등 |
| 문서화 | 최소한 | API 문서 / 예제 상대적으로 충실 |
참고: gsplat 계열 대안으로 ds-splat도 후보에 있었는데, 유지보수 지속성과 생태계(nerfstudio 연동)를 보고 gsplat을 택했다. Inria같은 경우 업데이트가 없으면 오로지 논문 중심으로만 운영하기때문에 오류가 있더라도 수정이 되지 않는 경우가 있다. 대표적으로 prune이다. 이유는 아래 상세하게 작성되있다.
2. 커널 구조 & API 설계
INRIA 원본은 논문 재현을 목표로 만들어져서, forward/backward가 하나의 큰 흐름으로 묶여 있고 내부를 뜯어보려면 커널 코드를 직접 읽어야 한다. "돌아가는 레퍼런스"로는 훌륭하지만, 코어만 떼어내 다른 파이프라인에 이식하려면 결합도가 높은 편.
gsplat은 상대적으로 모듈화가 잘 되어 있다. projection / rasterization 단계가 좀 더 분리돼 있고, 파이썬 레이어에서 각 단계를 조합하기 쉽게 설계돼 있다. 속도적인 측면에서 장점이 크다 아마 prune이 빠져서 그런게 크다 코어층은 각 모델들에 따라서 차이가 있지만 이후의 Densify이라던지 다른 기법들이 차이가 있어 속도적인 측면에 가장 큰 이점을 같는다.
참고로 나는 PyTorch 레이어를 통째로 가져오는 방식이 아니라 .cu 커널만 추출해서 이식하는 접근을 택했다. (Python/PyTorch 의존성을 최소화하려는 목적) 그래서 아래 "포팅 시 걸림돌"이 특히 중요했다.
densification이 모듈로 교체 가능하다는 점도 gsplat의 큰 장점이다. INRIA 원본은 Adaptive Density Control(ADC) 로직이 학습 루프에 박혀 있어 다른 전략을 쓰려면 코드를 직접 뜯어야 한다. 반면 gsplat은 원본 ADC뿐 아니라 Absgrad(Ye et al. 2024), MCMC(Kheradmand et al. 2024) 같은 최신 densification 전략을 모듈 API로 갈아끼울 수 있고, Mip-Splatting의 2D anti-aliasing 모드도 지원한다. 원본에서 같은 걸 하려면 별도 포크나 수동 패치가 필요하다.
*** 매우 중요: 트러블슈팅: iter 3000 즈음 가우시안이 갑자기 대량 소멸 ***
gsplat 학습을 돌리다 보면 특정 iteration(대략 3000 부근)에서 가우시안 수십만 개가 한꺼번에 사라지면서 씬이 무너지는 현상을 만날 수 있다. loss가 갑자기 튀거나 화면이 뻥 뚫린 것처럼 비어버린다.
원인 — 화면 크기 기반 prune (max_screen_size / big-screen prune) 원본 3DGS의 densification에는 "화면상에서 너무 커진 가우시안을 제거하는" prune이 있다. 이 규칙은 opacity reset 주기(기본 3000 iter)를 넘긴 뒤부터 size_threshold(기본 20px)로 활성화된다. 문제는 스케일 초기화·좌표계·타일 처리가 살짝만 어긋나 있어도, 이 시점에 정상 가우시안까지 "화면상 너무 큼"으로 오판돼 무더기로 잘려나간다는 것. 실제로 이 지점에서 350k개 이상이 한 번에 삭제되는 경우도 봤다.
해결 — max_screen_size = 0 (화면 크기 기반 prune 비활성화) 가장 확실한 처방은 이 prune을 꺼버리는 것이다. max_screen_size를 0(또는 None)으로 두면 화면 크기 기반 삭제가 동작하지 않아 대량 소멸이 사라진다. 불투명도 기반 prune은 그대로 남으므로 학습 자체엔 지장이 없다.
# 문제: 3000 iter 이후 big-screen prune이 정상 점까지 삭제
# 처방: 화면 크기 기반 prune 끄기
max_screen_size = 0   # (기본 20 → 0)
근본 원인이 스케일/좌표계 세팅 쪽일 수도 있으니, prune을 끄고도 학습 품질이 이상하면 초기 스케일 추정(kNN)과 카메라 컨벤션을 다시 점검할 것. 경험적으로 코어를 변경하며 연결이 바뀌어 값이 달라질 수도 있지만 기본적으로 nerf코어에서의 prune은 exp의 값이 6, 7이상 까지도 뛰며 prune 과정에서 값을 넘는 splats 들은 날려버리기 때문에 단점이 많은 기법이다.
실제로 gsplat v1.0.0 기준으로 prune에 대한 오류 주석도 남아있음.
참고: gsplat은 densification 전략(ADC / Absgrad / MCMC)을 모듈로 교체할 수 있어서, prune 정책이 마음에 안 들면 아예 다른 전략으로 갈아끼우는 것도 방법이다.
3. 포팅하면서 실제로 걸린 것들
여기가 이 글의 핵심. 두 구현이 "같은 3DGS"라고 해서 함수를 그냥 바꿔 끼울 수 있는 게 아니다. 컨벤션 차이를 하나씩 맞춰야 결과가 나온다.
- 쿼터니언 순서 (wxyz vs xyzw) 회전 표현 순서가 다르면 스플랫이 통째로 틀어진다. 어느 쪽이 w를 앞에 두는지부터 확인해야 함. 실제로 축 순서가 바뀌면 렌더 과정에서 회전이 뒤집히는 현상을 겪는다 제대로 확인하고 회전 연산을 적용하기 해야함.
- SH(구면 조화 함수) 레이아웃 SH 계수의 저장 순서·채널 배치가 구현마다 다르다. degree, 계수 개수, [coef][rgb] vs planar 배치 등을 맞추지 않으면 색이 깨진다.
- 카메라 좌표계 컨벤션 view/world 변환, 축 방향(+Z front 여부) 등이 다르면 카메라가 뒤집히거나 씬이 안 보인다.
- conic 부호 / 공분산 처리 2D conic 계산 시 부호 규약이 어긋나면 블렌딩이 깨진다.
- 그래디언트 누적 (backward) atomicAdd 방식·누적 대상이 미묘하게 달라서, 학습이 도는데 수렴이 이상한 형태로 나타날 수 있다.
4. 부수적으로 갈아야 했던 것
래스터라이저만 바꾼다고 끝이 아니었다. 초기 스케일 추정에 쓰던 simple-knn도 라이선스/구성상 함께 교체 대상이었다.
5. 성능 & 품질 비교
5.1 문서화된 일반 차이 (참고)
내 실측과 별개로, gsplat이 공식적으로 밝히는 성능 이점은 이렇다:
- Mip-NeRF 360 캡처 기준 학습 메모리 최대 ~4배 절감, 학습 시간 최대 ~15% 단축, 대규모 씬일수록 이득이 커진다.
- 대규모 씬 렌더링에선 공식 CUDA 백엔드 대비 수십 배 빠르게 설계됐다.
단, 만능은 아니다. 이미지 15장 수준의 작은 데이터셋에선 gsplat이 오히려 vanilla 3DGS보다 느리다는 보고도 있다. 즉 이득은 주로 큰 씬에서 나오고, 작은 씬만 다루면 체감 차이가 없거나 역전될 수 있다.
5.2 내 실측
측정 환경
- GPU:RTX 5070, VRAM 12GB
- 데이터셋 / 씬: Mip-NeRF 360 — Garden
- 해상도: images_4 / 1297×840
- 학습 iteration: 30,000
해상도 세팅을 반드시 명시할 것. Mip-NeRF 360은 논문마다 학습 해상도가 다르다. 3D-GS 표준은 야외 씬에 images_4(원본 4배 다운스케일), 실내 씬에 images_2를 쓴다. 예를 들어 Garden(야외) 은 원본 ~5187×3361 → images_4 기준 1297×840 로 학습하는 게 관례다. 이걸 안 밝히면 다른 사람 PSNR과 비교했을 때 조건이 안 맞아 무의미한 비교가 된다.
참고: 이미지를 다운스케일해도 카메라 포즈(extrinsics)는 불변이고, 픽셀 단위인 intrinsics(fx, fy, cx, cy)만 배율만큼 스케일해주면 학습이 정상적으로 된다. (카메라를 FoV 각도로 저장하는 구현은 해상도 무관이라 자동으로 맞아떨어진다.)
Part C. 종합 판단 — 그래서 뭘 골랐나
6. 진짜 결정 요인은 라이선스였다
기술적 차이도 있었지만, 최종 선택을 가른 건 라이선스였다.
- INRIA diff-gaussian-rasterization은 비상업(non-commercial) 라이선스다. 그리고 중요한 점 — 이 제약은 코드를 수정해도 그대로 따라온다. "내가 좀 고쳤으니 괜찮겠지"가 안 통한다. 상업적으로 배포하려면 (a) 커널을 완전히 교체하거나 (b) Inria로부터 별도 상업 라이선스를 받는 수밖에 없다.
- gsplat은 Apache 2.0이다. 상업 배포·재배포가 가능하고, 특허 조항까지 포함돼 있어 프로덕션에 훨씬 안전하다.
내 경우엔 상업 배포 / Fab 등록 등이 목표였으니, 사실상 선택지가 없었다.
하지만 포팅을 어느정도 한 입장에서는 gsplat의 장점이 훨씬 크다 최적화 기법도 많이 적용되있으며 논문에 비해 업데이트가 꾸준히 되고 있기에 다른 측면에서 보면 gsplat는 INRIA에 비해 장점밖에 없다.
7. 정리: 언제 뭘 쓸까
INRIA 원본이 나은 경우
- 논문 재현, 연구, 알고리즘 학습 목적
- 상업 배포 계획이 없는 개인/학술 프로젝트
- "레퍼런스와 100% 동일한 baseline"이 필요할 때
gsplat이 나은 경우
- 상업 제품 / 재배포가 필요한 경우 (라이선스)
- 대규모 씬 — 메모리·속도 이점이 여기서 크게 난다
- 활발한 유지보수·생태계(nerfstudio 등)를 활용하고 싶을 때
- 커널을 모듈 단위로 조합·확장하거나, 최신 densification(absgrad/MCMC)·anti-aliasing을 갈아끼우고 싶을 때
8. 마무리
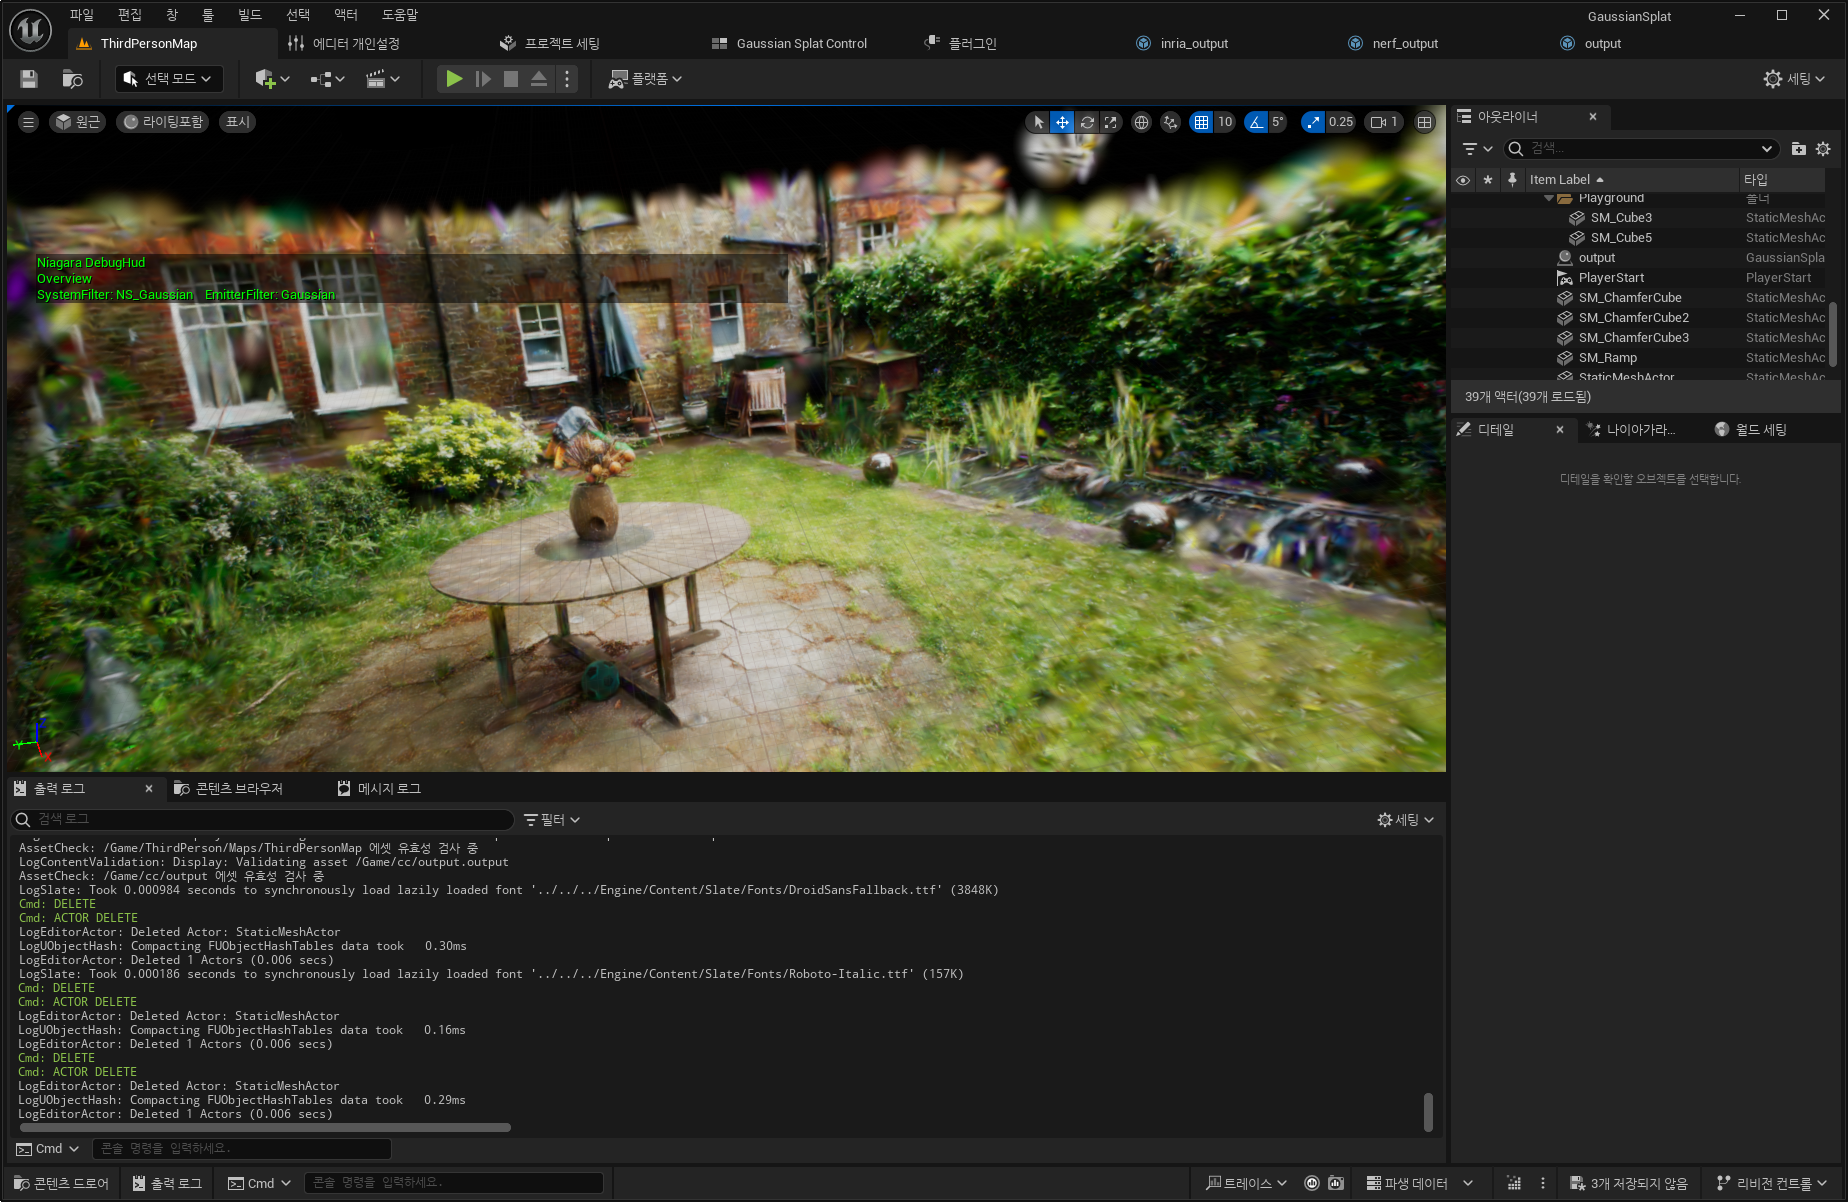
INRIA와 nerf의 gsplat 두 가지 모델을 사용해보며 각 구현점마다 장점이 있으며 개인적인 견해가 강한 리뷰이기에 만약 gsplat에 대해 성능이 궁금한다면 포팅 모델에 대해 아래 링크를 통해 사용해보길 바랍니다.
링크: https://github.com/codakcoo/BAEKGS/releases/tag/v1.0.0
참고 / 출처 (Attribution)
- 3D Gaussian Splatting (Kerbl et al., 2023) — https://arxiv.org/abs/2308.04079
- INRIA diff-gaussian-rasterization — https://github.com/graphdeco-inria /gaussian-splatting
- gsplat — nerfstudio-project (Apache 2.0), https://github.com/nerfstudio-project/gsplat
- COLMAP — https://github.com/colmap/colmap
'3D Gaussian Splatting' 카테고리의 다른 글
| 논문 리뷰: 3D Gaussian Splatting for Real-Time Radiance Field Rendering (0) | 2026.07.29 |
|---|